<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://shengbinxu.github.io/feed.xml" rel="self" type="application/atom+xml" /><link href="https://shengbinxu.github.io/" rel="alternate" type="text/html" /><updated>2026-10-06T08:11:28+08:00</updated><id>https://shengbinxu.github.io/feed.xml</id><title type="html">大斌的技术笔记</title><subtitle>后端、AI 工程化，以及一些实测记录</subtitle><author><name>大斌</name></author><entry><title type="html">OpenViking 代码问答对照实验：本地直读、语义检索、VikingBot 三组实测</title><link href="https://shengbinxu.github.io/2026/10/ai-codebase-qa-benchmark/" rel="alternate" type="text/html" title="OpenViking 代码问答对照实验：本地直读、语义检索、VikingBot 三组实测" /><published>2026-10-05T08:00:00+08:00</published><updated>2026-10-05T08:00:00+08:00</updated><id>https://shengbinxu.github.io/2026/10/ai-codebase-qa-benchmark</id><content type="html" xml:base="https://shengbinxu.github.io/2026/10/ai-codebase-qa-benchmark/"><![CDATA[<h2 id="一需求背景">一、需求背景</h2>

<p>我们要做的是一个<strong>基于多仓库代码的问答 Agent</strong>，落在群里，让不写代码的人也能直接问代码。</p>

<p>使用者主要是三类：</p>

<table class="table-wide">
  <thead>
    <tr>
      <th>角色</th>
      <th>典型问题</th>
      <th>现状</th>
      <th>痛点</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>产品经理</td>
      <td>“这个需求现在是怎么实现的？改动会波及哪几个服务？”</td>
      <td>群里 @ 研发口头问</td>
      <td>打断研发；回答零散、口径不一</td>
    </tr>
    <tr>
      <td>新人</td>
      <td>“这个功能在哪个仓库、哪个模块？这条链路经过哪几个服务？”</td>
      <td>自己 grep + 翻文档 + 问人</td>
      <td>熟悉期被拉长；grep 在几十个仓库里基本失效</td>
    </tr>
    <tr>
      <td>值班 / 排障</td>
      <td>“这个配置项在哪里生效？谁在消费这个 topic？”</td>
      <td>靠记忆和搜索</td>
      <td>排障时最贵的是”找人问”那几分钟</td>
    </tr>
  </tbody>
</table>

<p>这三类问题有个共同点：<strong>答案散落在多个仓库里，而提问者不掌握仓库边界</strong>。他只知道业务语义——”支付回调”——不知道对应的代码叫 <code class="language-plaintext highlighter-rouge">PaymentCallbackHandler</code> 还是 <code class="language-plaintext highlighter-rouge">pay_notify_consumer</code>。关键词搜索在这里几乎帮不上忙，这正是语义检索该发力的地方。</p>

<p>不过方案要落地，得先回答两个问题：<strong>回答能不能变快，质量会不会掉。</strong> 这两个不清楚，后面推不动。</p>

<p>火山引擎开发者社区那篇<a href="https://developer.volcengine.com/articles/7622857325355171849">《OpenViking 实战教程：搭建多仓库代码语义检索系统》</a>给了我很强的参考：它直接用 157 个真实仓库做了 10 道题的三组对照，结论是 VikingBot 最好，”较好”评级 90%。那是贴近真实规模的一次验证。</p>

<p>我的做法不一样，是<strong>先退一步做可控验证</strong>：把语料缩到单个仓库，把问题设计成答案可客观判定，先把”语义检索本身值多少、质量会不会掉”这两个变量量出来。多仓库场景留到后面（第六节第 3 小节会拿官方的数据做对照）。</p>

<h2 id="二实验设计">二、实验设计</h2>

<p>语料选 <strong>nanobot</strong>（HKUDS 的开源 Agent 框架，Python，1686 个文件 / 20MB / commit <code class="language-plaintext highlighter-rouge">13cec01</code>）。选它的理由：体量适中，全量索引进 OpenViking 只花了 316 秒、299 万 token，成本可控；同时它有真实的复杂度，四道题都能落到具体源码上。</p>

<p>三组设置如下：</p>

<table class="table-wide">
  <thead>
    <tr>
      <th> </th>
      <th>对照组</th>
      <th>实验组 1</th>
      <th>实验组 2</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>做法</td>
      <td>本地直读</td>
      <td>Agent + OpenViking</td>
      <td>VikingBot</td>
    </tr>
    <tr>
      <td>代码来源</td>
      <td>本地 clone <code class="language-plaintext highlighter-rouge">/tmp/nanobot-bench/nanobot</code></td>
      <td>仅 OV 语料 <code class="language-plaintext highlighter-rouge">viking://user/default/resources/nanobot</code></td>
      <td>仅 OV 语料</td>
    </tr>
    <tr>
      <td>Agent 实体</td>
      <td>dsh 子代理（<code class="language-plaintext highlighter-rouge">read</code>/<code class="language-plaintext highlighter-rouge">grep</code>/<code class="language-plaintext highlighter-rouge">glob</code>/<code class="language-plaintext highlighter-rouge">bash</code>）</td>
      <td>dsh 子代理 + <code class="language-plaintext highlighter-rouge">mcp__openviking__*</code></td>
      <td>VikingBot（<code class="language-plaintext highlighter-rouge">ov chat</code>，与 <code class="language-plaintext highlighter-rouge">/studio/vikingbot</code> 同一 AgentLoop）</td>
    </tr>
    <tr>
      <td>工具约束</td>
      <td>禁用 OV 工具</td>
      <td>仅允许 OV 工具，禁用本地文件工具</td>
      <td>无显式约束</td>
    </tr>
    <tr>
      <td>磁盘上有仓库副本</td>
      <td>有</td>
      <td><strong>无</strong></td>
      <td><strong>无</strong></td>
    </tr>
  </tbody>
</table>

<p>实验组 1 是这次设计的关键。官方那篇的对照组（本地 workspace）和实验组 2（VikingBot）同时变了两个量：<strong>检索来源</strong>和<strong>Agent 框架</strong>。只比这两组，无法判断差异来自语义检索本身，还是来自 bot 的工作方式。实验组 1 固定 Agent 框架不变、只把检索来源换成 OpenViking，就把这个变量分离出来了。</p>

<h2 id="三题目">三、题目</h2>

<p>四道题都要求跨 4 个以上文件才能答完整，且答案可以客观判定：</p>

<ol>
  <li><strong>上下文超窗</strong>：一次请求的上下文即将超出模型窗口时，nanobot 依次做了哪些处置？触发判定在哪个环节、裁剪与保留的优先级、压缩产物如何回到后续请求。</li>
  <li><strong>消息链路</strong>：一条来自渠道的消息从被收到到回复写回，经过哪些对象与队列？同一 session 上一条回复尚未发出时又来一条，会发生什么。</li>
  <li><strong>状态隔离</strong>：同一进程内多个 AgentLoop / 多个 session 时，哪些状态独享、哪些共享？给一个”不隔离就会出错”的具体例子。</li>
  <li><strong>模型优先级</strong>：<code class="language-plaintext highlighter-rouge">modelPresets</code>、全局 provider 配置、session 级模型选择三者同时存在时，谁说了算。</li>
</ol>

<p>第四题埋了前提陷阱。题干把三者写成并列的三层，但源码里它们不在同一维度上（<code class="language-plaintext highlighter-rouge">modelPresets</code> 是候选项目录，<code class="language-plaintext highlighter-rouge">providers.*</code> 是横切凭据层，真正构成覆盖关系的只有”实例默认 vs session 级”）。能否识破这一点，是区分作答深度的信号。</p>

<h2 id="四评分方法">四、评分方法</h2>

<p><strong>先定标准，再跑题。</strong> 四个独立子代理分别精读源码，每道题产出 10 条”必中要点”，每条附 <code class="language-plaintext highlighter-rouge">文件:行号</code> 证据。这份清单在跑题之前定稿，避免事后倒推标准。</p>

<p><strong>物理隔离。</strong> 实验组 1、2 需要证明”没有本地仓库也能答好”，所以跑之前把仓库删掉，答案清单也压缩改名藏到别处。事后审计两个实验组的工具调用日志，确认零次触碰封存路径。</p>

<p><strong>匿名评分。</strong> 收齐答案后，把引用格式归一化（<code class="language-plaintext highlighter-rouge">viking://.../bus/queue.py</code> → <code class="language-plaintext highlighter-rouge">bus/queue.py</code>）、随机打乱顺序、隐去来源，交给未参与作答的子代理评分。评分纪律写死在提示词里：不因篇幅长加分、不因提到某种检索工具加减分、某维度相当就写”相当”。</p>

<p>指标：<strong>关键结论命中率</strong>（10 条要点命中几条，部分命中算 0.5）、<strong>引用可核对率</strong>（抽 8 条引用到源码逐条核实）、<strong>事实错误数</strong>。</p>

<h2 id="五结果">五、结果</h2>

<h3 id="耗时">耗时</h3>

<table>
  <thead>
    <tr>
      <th> </th>
      <th>四题总耗时</th>
      <th>相对对照组</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>对照组（本地直读）</td>
      <td>657 秒</td>
      <td>1.00×</td>
    </tr>
    <tr>
      <td>实验组 1（Agent + OV）</td>
      <td>588 秒</td>
      <td>1.12×</td>
    </tr>
    <tr>
      <td><strong>实验组 2（VikingBot）</strong></td>
      <td><strong>241 秒</strong></td>
      <td><strong>2.73×</strong></td>
    </tr>
  </tbody>
</table>

<h3 id="质量">质量</h3>

<table>
  <thead>
    <tr>
      <th>题目</th>
      <th>对照组</th>
      <th>实验组 1</th>
      <th>实验组 2</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>上下文超窗</td>
      <td>10</td>
      <td>10</td>
      <td>9.5</td>
    </tr>
    <tr>
      <td>消息链路</td>
      <td>9</td>
      <td>7.0</td>
      <td>2.5 *</td>
    </tr>
    <tr>
      <td>状态隔离</td>
      <td>10</td>
      <td>9</td>
      <td>9</td>
    </tr>
    <tr>
      <td>模型优先级</td>
      <td>9.5</td>
      <td>9</td>
      <td>8.0</td>
    </tr>
    <tr>
      <td><strong>平均</strong></td>
      <td><strong>9.63</strong></td>
      <td><strong>8.75</strong></td>
      <td><strong>7.25</strong></td>
    </tr>
    <tr>
      <td>引用可核对率（Q1–Q4）</td>
      <td>8/8、8/8、7/8、8/8</td>
      <td>7/8、8/8、7/8、7/8</td>
      <td>8/8、<strong>0/8</strong>、6/8、5/8</td>
    </tr>
  </tbody>
</table>

<p>* 该格受一次环境干扰影响（bot 读到了本机同源的 <code class="language-plaintext highlighter-rouge">vikingbot</code> 安装包，而非索引语料），排除后为 7.5 分。这属于部署配置问题，不是检索能力问题，后文第六节会说明怎么防。</p>

<h3 id="过程量">过程量</h3>

<table>
  <thead>
    <tr>
      <th> </th>
      <th>对照组</th>
      <th>实验组 1</th>
      <th>实验组 2</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>工具调用次数</td>
      <td>223</td>
      <td>203</td>
      <td><strong>127</strong></td>
    </tr>
    <tr>
      <td>读取字节数</td>
      <td>453 KB</td>
      <td>666 KB</td>
      <td>未上报</td>
    </tr>
    <tr>
      <td>把关键机制说反</td>
      <td>0 处</td>
      <td>0 处</td>
      <td><strong>4 处</strong></td>
    </tr>
  </tbody>
</table>

<h2 id="六分析与发现">六、分析与发现</h2>

<h3 id="1-vikingbot-的-273-倍来自做得更少不是检索更快">1. VikingBot 的 2.73 倍来自”做得更少”，不是”检索更快”</h3>

<p>把工具调用次数和耗时摆在一起就很清楚了：VikingBot 全程只调了 <strong>127 次</strong>工具，对照组 223 次，实验组 1 是 203 次。它的答案体量也最小（27.5 KB vs 对照组的 77.6 KB）。</p>

<p>也就是说，VikingBot 快是因为它干的活最少。</p>

<p>那 OpenViking 的语义检索本身值多少？看实验组 1——<strong>同一个 Agent 框架，只把检索来源换掉，快了 11%</strong>。语义检索的速度收益就这么大。它真正的好处不是快，而是<strong>代码不在磁盘上也能读</strong>，本轮实验里它读了 666 KB，比本地直读的 453 KB 还多。</p>

<h3 id="2-速度和质量是同一条标尺的两端">2. 速度和质量是同一条标尺的两端</h3>

<p>按耗时排序：VikingBot（241 秒，7.25 分）→ 实验组 1（588 秒，8.75 分）→ 对照组（657 秒，9.63 分）。</p>

<p>基本单调。答得越细越慢，没有免费的午餐。</p>

<p>这个排序其实是个好消息：它说明”VikingBot 质量偏低”不是能力上限，而是<strong>当前的工作量设置偏保守</strong>。想提质量应该调框架层——提高检索和阅读的轮次预算、在系统提示里强制”引用之前必须把源码打开核对”。积木是够的，实验组 1 连本地仓库都没有，照样拿到 8.75 分且零机制判反。</p>

<h3 id="3-和官方测评的对照">3. 和官方测评的对照</h3>

<p>官方那篇的结论是 VikingBot 最好（”较好”评级 90%，对照组只有 40%）。我的结果里 VikingBot 质量最低。这并不矛盾，因为两边的设定差得很远：</p>

<table>
  <thead>
    <tr>
      <th> </th>
      <th>官方测评</th>
      <th>本次实验</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>语料规模</td>
      <td>157 个代码仓库</td>
      <td>1 个仓库、1686 文件</td>
    </tr>
    <tr>
      <td>题目数量</td>
      <td>10 题（团队真实场景）</td>
      <td>4 题（跨文件机制分析）</td>
    </tr>
    <tr>
      <td>评分方式</td>
      <td>问题负责人评”较好/一般/较差”</td>
      <td>事前要点清单 + 匿名判分</td>
    </tr>
    <tr>
      <td>对照组</td>
      <td>本地 workspace + OpenCode</td>
      <td>本地 clone + dsh 子代理</td>
    </tr>
  </tbody>
</table>

<p>官方测的是<strong>跨仓库、需求理解类</strong>的问题，那里语义检索的价值最大——grep 在一百多个仓库里翻”支付回调”确实找不到北。我测的是<strong>单仓库、机制分析类</strong>问题，答案要精确到文件和行号，这种任务里”多读几遍源码”比”检索得准”更重要，所以工作量的差异压过了检索方式的差异。</p>

<h2 id="七这套方法给出的三条启发">七、这套方法给出的三条启发</h2>

<p><strong>第一，先给你的问题分类，再决定要不要上语义检索。</strong></p>

<p>判断标准很简单：<strong>答案能不能靠”多读几遍代码”逼近</strong>。</p>

<ul>
  <li>跨仓库、意图模糊（”支付回调在哪”、”这个需求的实现思路”）——搜索空间太大，本地 grep 的召回率上不去，语义检索的收益最大。</li>
  <li>单仓库、机制精确（”这个状态机怎么流转”、”为什么这里加锁”）——答案就藏在几个文件里，多读几轮就能拿到，检索方式的影响很小。</li>
</ul>

<p>我们团队最初想在单仓库场景上验证收益，测下来发现<strong>收益主要来自框架的工作量配置，而不是检索方式本身</strong>。这个结论改变了我们的推进顺序。</p>

<p><strong>第二，把”检索来源”和”Agent 框架”分开测，否则你会归因错误。</strong></p>

<p>这一条是整套方法里最值得复用的部分。如果只跑官方那种”对照组 vs VikingBot”的两组设计，你会看到 2.73 倍的提速，然后自然地把它归功于语义检索。加了固定框架的第三组之后才发现，语义检索只值 11%，其余全是”干得少”。</p>

<p>任何涉及两个变量的对照实验都有这个陷阱：<strong>换的东西越多，测完越不知道自己测到了什么。</strong></p>

<p><strong>第三，部署时的两个坑会吃掉你的收益，而且都不在文档里。</strong></p>

<p>一是<strong>宿主环境不能有与被索引代码库同源的副本</strong>。这次实验组 2 在”消息链路”题上只拿到 2.5 分，就是因为它读到了本机安装的同源包而不是索引语料——行号全错。系统提示里必须写死”只能依据索引语料作答”。</p>

<p>二是<strong>跑评测必须锁定 commit</strong>。我隔天重新拉代码，上游已经推了几个提交，一个核心文件从 2568 行长到 2601 行，此前所有行号引用当场作废。用归档包按 commit 拉才对齐。</p>

<h2 id="八成本参考">八、成本参考</h2>

<p><strong>索引成本比想象中低。</strong> 1686 个文件、299 万 token、316 秒，折算约<strong>每个文件 1800 token</strong>。一万个文件大约 1800 万 token、四十分钟。</p>

<p>成本几乎全在大模型摘要上（占 token 总量的 58–83%），不在向量化——想省钱应该换便宜的摘要模型，换嵌入服务没用。</p>

<p>对 157 个仓库那种规模，这是一次性投入，摊到日常问答里很快就能回来。</p>

<h2 id="九局限">九、局限</h2>

<p><strong>单次运行，噪声已量化。</strong> 每格跑一次。实验组 1 测过两轮，均值分别是 9.13 和 8.75，<strong>极差 0.38 分</strong>。小于这个幅度的差距不该当结论——比如 Q1 对照组 10 分、实验组 2 是 9.5 分，就落在噪声里，我不把它当作有效差异。</p>

<p><strong>实验组 1 是”无本地代码”场景的近似，不是等价物。</strong> 它仍与对照组跑在同一个 Agent 宿主里，只是抽掉了磁盘副本；真实产品里 Agent 还隔着群聊协议、鉴权和用户身份层，那些环节本轮完全没有覆盖。</p>

<p><strong>样本量支撑不了普适结论。</strong> 4 道题 × 单轮，只能作为方向性证据。</p>

<p><strong>最关键的一条：本轮语料只有一个仓库，而真实需求是多仓库。</strong> 1686 个文件放在几十上百个仓库里，召回难度完全不是一个量级——”支付回调”这类业务语义问题，在单仓库里靠 grep 加人工翻还能兜住，在多仓库里基本失效。<strong>所以本轮数据不能直接外推到多仓库场景</strong>；第六节第 3 小节拿官方的 157 仓库数据做参照，但那不是我自己的实测。</p>

<h2 id="十复现">十、复现</h2>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c"># 语料准备（约 5 分钟、299 万 token）</span>
<span class="c"># add_resource(path="https://github.com/HKUDS/nanobot.git",</span>
<span class="c">#              to="viking://~/resources/nanobot")</span>

<span class="c"># 对照组：克隆后由子代理作答（限 read/grep/glob/bash）</span>
git clone <span class="nt">--depth</span> 1 https://github.com/HKUDS/nanobot.git /tmp/nanobot-bench/nanobot

<span class="c"># 实验组：删掉本地 clone，再用 Agent / VikingBot 逐题作答</span>
ov chat <span class="nt">-s</span> bench-Q1 <span class="nt">-m</span> <span class="s2">"</span><span class="si">$(</span><span class="nb">cat </span>q1.txt<span class="si">)</span><span class="s2">"</span> <span class="nt">--no-format</span>
<span class="c"># 工具调用序列从 ~/.openviking/workspace/bot/logs/vikingbot.log 的 [TOOL_CALL] 提取</span>
</code></pre></div></div>

<p>评测环境：OpenViking 0.4.23 + VikingBot（<code class="language-plaintext highlighter-rouge">--with-bot</code>），模型 deepseek-flash，嵌入腾讯云 TokenHub 1024 维。语料 commit <code class="language-plaintext highlighter-rouge">13cec01</code>，<strong>上游此后已推进，复现必须锁定该 commit</strong>。</p>

<hr />

<h3 id="参考">参考</h3>

<ul>
  <li><a href="https://developer.volcengine.com/articles/7622857325355171849">OpenViking 实战教程：搭建多仓库代码语义检索系统，赋能 AI 助手 &amp; OpenClaw 记忆插件 2.0 升级</a> — 火山引擎开发者社区，本文的三组实验结构参考了这篇的设计</li>
  <li><a href="https://github.com/HKUDS/nanobot">HKUDS/nanobot</a> — 本次实验语料</li>
</ul>]]></content><author><name>大斌</name></author><category term="AI" /><category term="代码问答" /><category term="OpenViking" /><category term="评测" /><summary type="html"><![CDATA[把一个 1686 文件的代码库索引进 OpenViking，用 4 道跨文件难题跑三组对照。VikingBot 快 2.7 倍，但质量垫底——我把原因拆到了检索层和框架层。]]></summary></entry><entry><title type="html">flink 类加载剖析</title><link href="https://shengbinxu.github.io/2024/11/flink-classloader/" rel="alternate" type="text/html" title="flink 类加载剖析" /><published>2024-11-03T16:49:00+08:00</published><updated>2024-11-03T16:49:00+08:00</updated><id>https://shengbinxu.github.io/2024/11/flink-classloader</id><content type="html" xml:base="https://shengbinxu.github.io/2024/11/flink-classloader/"><![CDATA[<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Caused by: java.sql.SQLException: No suitable driver found for jdbc:mysql://25.79.1.13:90/tide_cloud?connectTimeout=60000&amp;socketTimeout=60000
        at java.sql.DriverManager.getConnection(DriverManager.java:689) ~[?:1.8.0_332]
        at java.sql.DriverManager.getConnection(DriverManager.java:247) ~[?:1.8.0_332]
        at org.apache.flink.connector.jdbc.catalog.MySqlCatalog.getDriverVersion(MySqlCatalog.java:159) ~[?:?]
        at org.apache.flink.connector.jdbc.catalog.MySqlCatalog.&lt;init&gt;(MySqlCatalog.java:93) ~[?:?]
        at com.tide.util.TableAssembler.build(TableAssembler.java:63) ~[?:?]
        at com.tide.Insight.prepare(Insight.java:112) ~[?:?]
        at com.tide.Insight.execute(Insight.java:104) ~[?:?]
        at com.tide.Insight.main(Insight.java:48) ~[?:?]
        at sun.reflect.NativeMethodAccessorImpl.invoke0(Native Method) ~[?:1.8.0_332]
        at sun.reflect.NativeMethodAccessorImpl.invoke(NativeMethodAccessorImpl.java:62) ~[?:1.8.0_332]
        at sun.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43) ~[?:1.8.0_332]
        at java.lang.reflect.Method.invoke(Method.java:498) ~[?:1.8.0_332]
        at org.apache.flink.client.program.PackagedProgram.callMainMethod(PackagedProgram.java:355) ~[flink-dist-1.17.1.jar:1.17.1]
        ... 7 more
</code></pre></div></div>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">public</span> <span class="kt">void</span> <span class="nf">invokeInteractiveModeForExecution</span><span class="o">()</span> <span class="kd">throws</span> <span class="nc">ProgramInvocationException</span> <span class="o">{</span>
        <span class="nc">FlinkSecurityManager</span><span class="o">.</span><span class="na">monitorUserSystemExitForCurrentThread</span><span class="o">();</span>
        <span class="k">try</span> <span class="o">{</span>
            <span class="n">callMainMethod</span><span class="o">(</span><span class="n">mainClass</span><span class="o">,</span> <span class="n">args</span><span class="o">);</span>
        <span class="o">}</span> <span class="k">finally</span> <span class="o">{</span>
            <span class="nc">FlinkSecurityManager</span><span class="o">.</span><span class="na">unmonitorUserSystemExitForCurrentThread</span><span class="o">();</span>
        <span class="o">}</span>
    <span class="o">}</span>
</code></pre></div></div>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code> this.mainClass =
                loadMainClass(
                        // if no entryPointClassName name was given, we try and look one up through
                        // the manifest
                        entryPointClassName != null
                                ? entryPointClassName
                                : getEntryPointClassNameFromJar(this.jarFile),
                        userCodeClassLoader);
</code></pre></div></div>

<p>mainClass是 ChildFirstClassLoader加载的，因此java.sql.DriverManager.getConnection也是ChildFirstClassLoader加载的。</p>

<p>因此，</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>//        log.info(java.sql.DriverManager.class.getClassLoader().toString());
 log.info(Insight.class.getClassLoader().toString());
 log.info(com.mysql.cj.jdbc.Driver.class.getClassLoader().toString());
</code></pre></div></div>

<p>输出：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>org.apache.flink.util.ChildFirstClassLoader@7d81f8b6
sun.misc.Launcher$AppClassLoader@12a3a380
</code></pre></div></div>

<p>ChildFirstClassLoader 是 Flink 自定义的类加载器，继承自 Java 的 ClassLoader 类，但它的工作机制和 AppClassLoader 不同。</p>

<p>ChildFirstClassLoader 会将子类加载器的类优先加载，而 AppClassLoader 则是按照默认的父类优先加载机制工作。</p>

<p>这两者之间并没有直接的继承关系或父子关系，而是独立存在的，用于不同的目的和场景。</p>

<p>去掉<code class="language-plaintext highlighter-rouge">classloader.parent-first-patterns.additional: com.mysql.; org.codehaus.</code>配置之后，</p>

<p>打印：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>org.apache.flink.util.ChildFirstClassLoader@69cebb68
org.apache.flink.util.ChildFirstClassLoader@69cebb68
</code></pre></div></div>

<p>这时候抱错了，提示<code class="language-plaintext highlighter-rouge">No suitable driver found for jdbc</code>，猜测原因：</p>

<ul>
  <li>java.sql.DriverManager是由Boostrap类加载器加载的</li>
  <li>com.mysql.cj.jdbc.Driver 是由ChildFirstClassLoader类加载器加载的。</li>
</ul>

<p><a href="https://juejin.cn/post/7249934982114672695">https://juejin.cn/post/7249934982114672695</a></p>

<h2 id="知识点">知识点</h2>

<p>1、任意一个类，都需要由<strong>加载它的类加载器和这个类本身一同确立其在Java虚拟机中的唯一性</strong>，每一个类加载器，都拥有一个独立的类名称空间。这句话可以表达更通俗一些：比较两个类是否”相等”，只有再这两个类是有同一个类加载器加载的前提下才有意义，否则，即使这两个类来源于同一个Class 文件，被同一个虚拟机加载，只要加载它们的类加载器不同，那这两个类就必定不相等。</p>

<p>2、类加载器本身不存在继承关系。 即使有双亲委派关系的存在，一个类的加载器，指的也是实际加载这个类的classLoader</p>

<p>3、每个线程绑定一个classLoader</p>]]></content><author><name>大斌</name></author><category term="flink" /><category term="JVM" /><summary type="html"><![CDATA[mainClass是 ChildFirstClassLoader加载的，因此java.sql.DriverManager.getConnection也是ChildFirstClassLoader加载的。]]></summary></entry><entry><title type="html">mybatis动态SQL</title><link href="https://shengbinxu.github.io/2024/10/mybatis-dynamic-sql/" rel="alternate" type="text/html" title="mybatis动态SQL" /><published>2024-10-30T18:19:00+08:00</published><updated>2024-10-30T18:19:00+08:00</updated><id>https://shengbinxu.github.io/2024/10/mybatis-dynamic-sql</id><content type="html" xml:base="https://shengbinxu.github.io/2024/10/mybatis-dynamic-sql/"><![CDATA[<p>目前项目中写动态SQL，用的都是下面的语法：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>@Select("&lt;script&gt;" +
            "SELECT wr.id,wr.customer_id,wr.type,wr.detail from xxx rel " +
            "LEFT JOIN xxx wr on rel.rule_id=wr.id where rel.entity_id=#{entityId} and wr.customer_id=#{customerId} " +
            "&lt;/script&gt;")
    List&lt;WarningRule&gt; queryByEntityId(@Param("entityId") Integer entityId,@Param("customerId")Integer customerId);
</code></pre></div></div>

<p>有以下几种优化方式：</p>

<p>1、大括号形式，免去字符串拼接SQL时忘记空格导致的语法错误问题。</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>@Select({
    "&lt;script&gt;",
    "SELECT wr.id, wr.customer_id, wr.type, wr.detail",
    "FROM xxx rel",
    "LEFT JOIN xxx wr ON rel.rule_id = wr.id",
    "WHERE rel.entity_id = #{entityId}",
    "AND wr.customer_id = #{customerId}",
    "&lt;/script&gt;"
})
List&lt;WarningRule&gt; queryByEntityId(@Param("entityId") Integer entityId, @Param("customerId") Integer customerId);
</code></pre></div></div>

<p>2、借助OGNL表达式，减少函数参数数量</p>

<blockquote>
  <p>OGNL（Object-Graph Navigation Language）是一种用于访问和操作对象图的表达式语言。它被广泛用于 Java 环境中，尤其是在 MyBatis 和其他框架中。OGNL 允许你以简洁的方式访问对象属性、调用方法以及进行逻辑运算。</p>
</blockquote>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>@Select("SELECT * FROM users WHERE id = #{user.id}")
User getUser(@Param("user") User user);
</code></pre></div></div>]]></content><author><name>大斌</name></author><category term="mybatis" /><category term="SQL" /><summary type="html"><![CDATA[目前项目中写动态SQL，用的都是下面的语法：]]></summary></entry><entry><title type="html">spring cloud bus</title><link href="https://shengbinxu.github.io/2024/09/spring-cloud-bus/" rel="alternate" type="text/html" title="spring cloud bus" /><published>2024-09-25T17:27:00+08:00</published><updated>2024-09-25T17:27:00+08:00</updated><id>https://shengbinxu.github.io/2024/09/spring-cloud-bus</id><content type="html" xml:base="https://shengbinxu.github.io/2024/09/spring-cloud-bus/"><![CDATA[<p><a href="https://cloud.tencent.com/developer/article/1669299">https://cloud.tencent.com/developer/article/1669299</a></p>

<p>微服务一般都采用集群方式部署，而且在高并发下经常需要对服务进行扩容、缩容、上线、下线的操作。比如我们需要更新配置，又或者需要同时失效所有服务器上的某个缓存，需要向所有相关的服务器发送命令，此时就可以选择使用 Spring Cloud Bus 了。</p>

<p>总的来说，就是在我们需要把一个操作散发到所有后端相关服务器的时候，就可以选择使用 Spring Cloud Bus 了。</p>]]></content><author><name>大斌</name></author><category term="spring cloud" /><category term="微服务" /><summary type="html"><![CDATA[微服务一般都采用集群方式部署，而且在高并发下经常需要对服务进行扩容、缩容、上线、下线的操作。比如我们需要更新配置，又或者需要同时失效所有服务器上的某个缓存，需要向所有相关的服务器发送命令…]]></summary></entry><entry><title type="html">Java Mock 框架Mockito背后的原理</title><link href="https://shengbinxu.github.io/2024/09/mockito-internals/" rel="alternate" type="text/html" title="Java Mock 框架Mockito背后的原理" /><published>2024-09-25T10:57:00+08:00</published><updated>2024-09-25T10:57:00+08:00</updated><id>https://shengbinxu.github.io/2024/09/mockito-internals</id><content type="html" xml:base="https://shengbinxu.github.io/2024/09/mockito-internals/"><![CDATA[<h2 id="遇到的问题">遇到的问题</h2>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>MockedStatic&lt;EnvUtil&gt; envUtilMockedStatic;
envUtilMockedStatic = Mockito.mockStatic(EnvUtil.class);
EnvUtil.setEnvironment(new StandardEnvironment());
</code></pre></div></div>

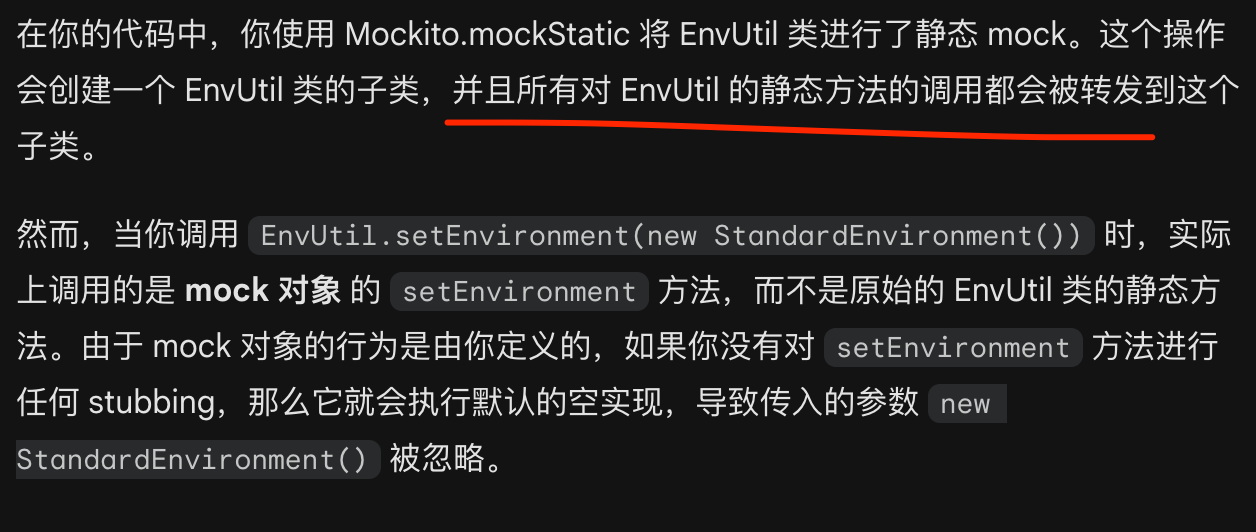
<p>mock了类EnvUtil之后，setEnvironment方法的参数始终为null。明明传的是一个对象。</p>

<h2 id="答案">答案</h2>

<p><img src="/assets/images/posts/mockito-internals/img-01.webp" alt="image" /></p>

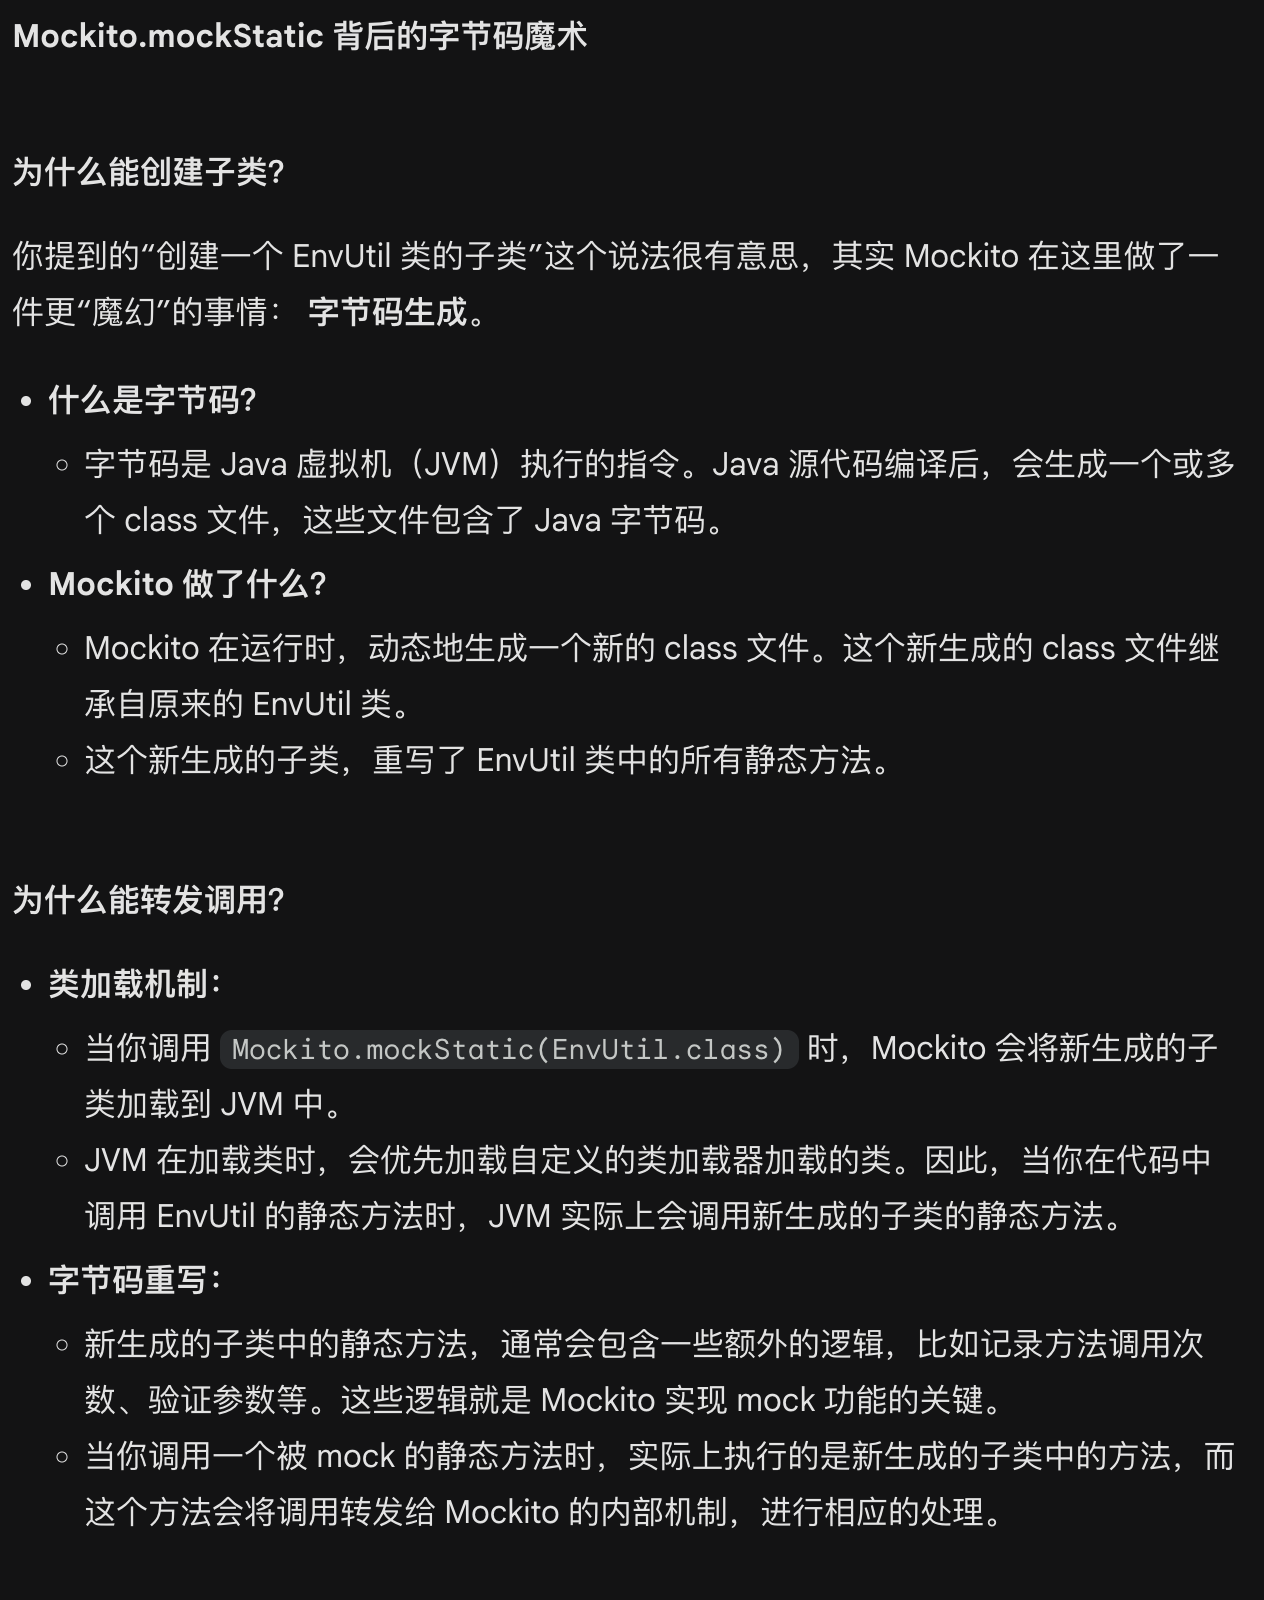
<p>“这个操作会创建一个 EnvUtil 类的子类，并且所有对 EnvUtil 的静态方法的调用都会被转发到这个子类” 这个背后的原理：</p>

<p><img src="/assets/images/posts/mockito-internals/img-02.webp" alt="image" /></p>

<h2 id="继续深究">继续深究</h2>

<p>1、经过验证，EnvUtil的类加载器还是应用类加载器，并不是自定义加载器。</p>

<p>2、还是不理解为啥参数是null，执行过程是怎样</p>]]></content><author><name>大斌</name></author><category term="java" /><category term="单元测试" /><summary type="html"><![CDATA[mock了类EnvUtil之后，setEnvironment方法的参数始终为null。明明传的是一个对象。]]></summary></entry><entry><title type="html">企业级无侵入式DNS方案</title><link href="https://shengbinxu.github.io/2024/09/enterprise-transparent-dns/" rel="alternate" type="text/html" title="企业级无侵入式DNS方案" /><published>2024-09-05T09:06:00+08:00</published><updated>2024-09-05T09:06:00+08:00</updated><id>https://shengbinxu.github.io/2024/09/enterprise-transparent-dns</id><content type="html" xml:base="https://shengbinxu.github.io/2024/09/enterprise-transparent-dns/"><![CDATA[<h2 id="参考资料">参考资料</h2>

<p><a href="https://blog.csdn.net/qq_36996635/article/details/126062991">https://blog.csdn.net/qq_36996635/article/details/126062991</a></p>

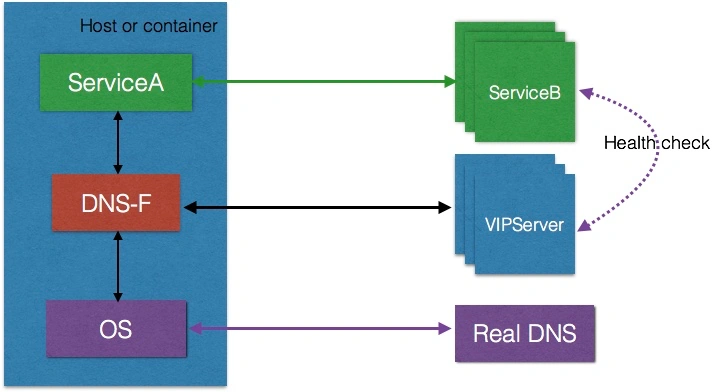
<p><img src="/assets/images/posts/enterprise-transparent-dns/img-01.webp" alt="image" /></p>

<ol>
  <li>首先，应用ServiceA通过DNS查询获取到ServiceB的可用IP列表</li>
  <li>DNS-F会拦截到ServiceA的查询请求，判断自己是否该查询的答案，如果有（服务已在VIPServer中注册）则直接返回IP列表；</li>
  <li>如果查询的服务在VIPServer中没有注册，DNS-F把DNS查询转发给系统的nameserver，由真正的DNS系统解析；</li>
</ol>

<p>这个方案太方便了，需要有配套的软件发布设施来保障，小公司不太适用。</p>

<h2 id="计划尝试的方案">计划尝试的方案</h2>

<p><a href="https://nacos.io/zh-cn/docs/v2/ecology/use-nacos-sync.html">https://nacos.io/zh-cn/docs/v2/ecology/use-nacos-sync.html</a><br />
 <a href="https://nacos.io/zh-cn/docs/v2/ecology/use-nacos-with-coredns.html">https://nacos.io/zh-cn/docs/v2/ecology/use-nacos-with-coredns.html</a></p>

<p>1、把eureka上的服务，同步到nacos</p>

<p>2、利用nacos dns能力，像使用dns一样无侵入式实现服务发现。<br />
 <code class="language-plaintext highlighter-rouge">dig   $nacos_service_name   @$dns_ip   -p $dns_port </code></p>

<p>在机器上配置一个dns地址，就能实现。</p>

<p>3、利用nacos实现对mysql等服务的dns功能。类似于百度的BNS，服务会提供主动的健康检查功能。<br />
 <a href="https://www.yuque.com/nacos/ebook/qrkw0g">https://www.yuque.com/nacos/ebook/qrkw0g</a></p>]]></content><author><name>大斌</name></author><category term="网络" /><category term="DNS" /><summary type="html"><![CDATA[首先，应用ServiceA通过DNS查询获取到ServiceB的可用IP列表 2. DNS-F会拦截到ServiceA的查询请求，判断自己是否该查询的答案，如果有（服务已在VIPServer中注册）则直接返回IP列表；…]]></summary></entry><entry><title type="html">几个场景下用flink如何解决的思考</title><link href="https://shengbinxu.github.io/2024/08/flink-scenario-practices/" rel="alternate" type="text/html" title="几个场景下用flink如何解决的思考" /><published>2024-08-20T23:27:00+08:00</published><updated>2024-08-20T23:27:00+08:00</updated><id>https://shengbinxu.github.io/2024/08/flink-scenario-practices</id><content type="html" xml:base="https://shengbinxu.github.io/2024/08/flink-scenario-practices/"><![CDATA[<h2 id="车辆gps流和车辆过地磅重量流union地磅数据最多晚到5天">车辆GPS流和车辆过地磅重量流union，地磅数据最多晚到5天</h2>

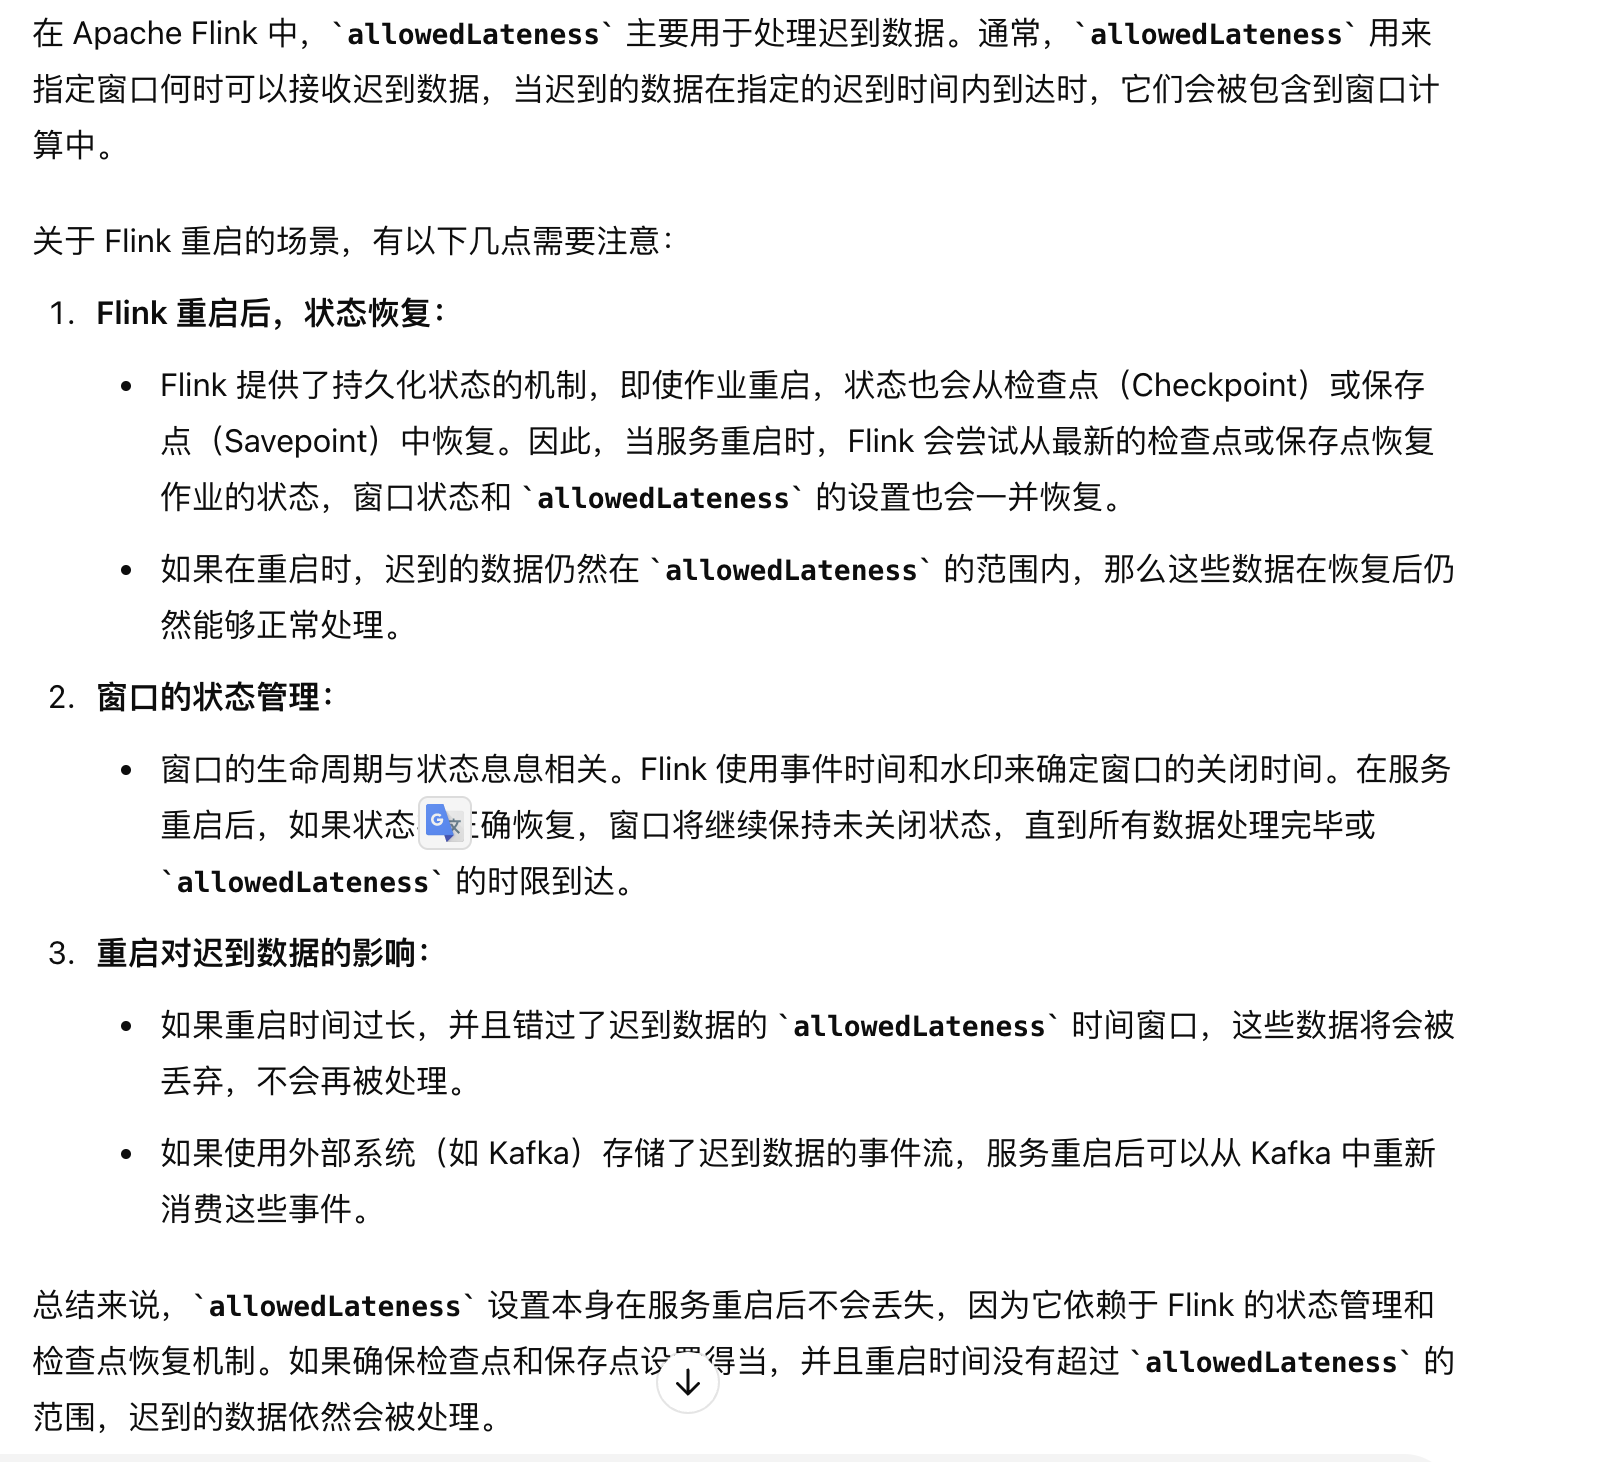
<p>使用allowedLateness(5d)可以让窗户等待5天再关闭。</p>

<h3 id="1第二天flink任务重启了迟到数据还能处理吗">1、第二天flink任务重启了，迟到数据还能处理吗？</h3>

<p><img src="/assets/images/posts/flink-scenario-practices/img-01.webp" alt="image" /></p>

<h3 id="2大部分车辆都没有称重数据如何提前关闭这些窗口避免过多浪费内存">2、大部分车辆都没有称重数据，如何提前关闭这些窗口，避免过多浪费内存</h3>

<p><img src="/assets/images/posts/flink-scenario-practices/img-02.webp" alt="image" /></p>

<p>设置allowedLateness(5d)</p>

<p>对于没有称重数据的车辆，当水印 &gt; 窗口最大时间，就可以考虑清除窗口的状态。</p>

<h2 id="1秒内气温升高超过1度进行报警">1秒内气温升高超过1度，进行报警</h2>

<p>利用KeyedProcessFunction中的定时器来实现。</p>

<p>定时器通常用来清除某些key对应的窗口的状态。</p>]]></content><author><name>大斌</name></author><category term="flink" /><category term="流计算" /><summary type="html"><![CDATA[使用allowedLateness(5d)可以让窗户等待5天再关闭。]]></summary></entry><entry><title type="html">反思线上问题定位效率</title><link href="https://shengbinxu.github.io/2024/08/online-troubleshooting-efficiency/" rel="alternate" type="text/html" title="反思线上问题定位效率" /><published>2024-08-20T09:24:00+08:00</published><updated>2024-08-20T09:24:00+08:00</updated><id>https://shengbinxu.github.io/2024/08/online-troubleshooting-efficiency</id><content type="html" xml:base="https://shengbinxu.github.io/2024/08/online-troubleshooting-efficiency/"><![CDATA[<h2 id="背景说明">背景说明</h2>

<p>我在排查 <a href="https://www.cnblogs.com/xushengbin/p/18368362">https://www.cnblogs.com/xushengbin/p/18368362</a> 问题过程中，前前后后花了超过16小时。</p>

<p>做了各种尝试，才搞明白原来是自己上周做了一个性能优化引入的问题。</p>

<p>定位问题原因时间成本很高，原因如下：</p>

<ol>
  <li>最近几天数据不一致的行数明显增多（1天2000多行），之前是稳定的100行。 这造成了干扰，让我无法对问题引入时间下确定性结论。因为到现在还不确定为啥每天有100条左右数据不一致（对用户影响较小，没有反馈类似问题）</li>
  <li>有考虑过可能是最近代码修改引入的问题，做过相关代码的review。但是这一条执行的不够彻底，没有对上游关联代码做check</li>
  <li>后来加了日志，基本能推断是乱序导致的。但是无法100%肯定，后来又加了花时间加了一些日志定位、分析问题。</li>
  <li>被问题表象困扰了。 每天设置一个window，允许1天的迟到数据。第二天凌晨5点会做当天数据初始化，此时，也触发了前一天window的计算，这个应该是合理的。 当时把心里花在：为啥会触发前一天的计算？即使触发了为啥会有bug，是不是代码逻辑有问题。 后来发现，trigger只是表象，最关键是前一天内存中数据已经乱序了。</li>
</ol>

<h2 id="教训">教训</h2>

<ol>
  <li>还是应该更多聚焦在引入问题诱因上。诱因找到了，问题就很容易修复。诱因分析要全面。 显然，我花了大量时间在分析各种可能性上，最终虽然问题解决了，但是时间成本真的太高了。</li>
  <li>知识盲区（如不知道为啥每天有100行左右的不一致数据）会增加问题分析的复杂度。</li>
</ol>

<p>好在问题还是解决了，这里面借助了阿里云SQL审计、内存数据写入DB等手段。</p>]]></content><author><name>大斌</name></author><category term="工程效率" /><category term="线上排查" /><summary type="html"><![CDATA[我在排查 问题过程中，前前后后花了超过16小时。]]></summary></entry><entry><title type="html">flink上下游并行度不一致导致的数据乱序问题</title><link href="https://shengbinxu.github.io/2024/08/flink-parallelism-out-of-order/" rel="alternate" type="text/html" title="flink上下游并行度不一致导致的数据乱序问题" /><published>2024-08-19T23:35:00+08:00</published><updated>2024-08-19T23:35:00+08:00</updated><id>https://shengbinxu.github.io/2024/08/flink-parallelism-out-of-order</id><content type="html" xml:base="https://shengbinxu.github.io/2024/08/flink-parallelism-out-of-order/"><![CDATA[<h2 id="问题描述">问题描述</h2>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>SingleOutputStreamOperator&lt;Row&gt; aggregatedStream = patrolStream
                .union(timerGarbageStream)
                .filter(v -&gt; v.getFacility() != null &amp;&amp; (v.getFacility().getType() == 11 || v.getFacility().getType() == 48))
                .setParallelism(12)
                .map(x -&gt; (PatrolRecord) x)
                .setParallelism(12)
                .filter(x -&gt; x.getInOutState() != 2)
                .setParallelism(12)
                .keyBy(v -&gt; (Integer) v.getFacility().getId())
                .window(TumblingEventTimeWindows.of(Time.seconds(86400), Time.seconds(-Constants.offsetSeconds)))
                .allowedLateness(Constants.allowedLateness)
                .trigger(CountAndEventTimeTrigger.of(1L))
                .aggregate(new GarbageReduceFunction(), new GarbageProcessWindowFunction())
                .setParallelism(12)
                .returns(rowTypeInfo);
</code></pre></div></div>

<p><img src="/assets/images/posts/flink-parallelism-out-of-order/img-01.webp" alt="image" /></p>

<p>算子A（红色）往侧流中写入数据：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>{"s":"2024-08-19 07:16:36","e":"2024-08-19 07:19:36","w":350000,"inferred":false,"rk":"DELETE","f_id":549737,"f_type":11,"inOutState":0,"loadCount":19}
{"s":"2024-08-19 07:16:36","e":"2024-08-19 07:19:36","w":318181,"inferred":false,"rk":"INSERT","f_id":549737,"f_type":11,"inOutState":0,"loadCount":19}
</code></pre></div></div>

<p>e是事件时间，相同的key、相同的事件时间，写入程序一定是先写入RowKind为DELETE的数据，后写入RowKind为INSERT的数据。</p>

<p>下游算子C（右下角）从侧流中消费数据，并写入DB。</p>

<p>问题在于，消费到的数据，部分数据的顺序乱了，先消费到RowKind为INSERT的数据，后消费到RowKind为DELETE的数据。</p>

<h2 id="问题分析">问题分析</h2>

<p>算子A（红色）的并行度是16</p>

<p>算子B（中间的filter）并行度是12</p>

<p>算子C（右下角）并行度是12</p>

<p>从A到B，进行了rebalance</p>

<blockquote>
  <p>rebalance 是一个数据重分布（redistribution）操作，它将上游算子的输出数据重新分配到下游的并行子任务中。rebalance 通过循环（round-robin）的方式将数据均匀地分配到所有下游任务槽（task slot）上，从而实现负载均衡。</p>
</blockquote>

<p>也就是说，这一步一定存在打乱顺序的可能性。可能出现的结果：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>key1、eventTime1、DELETE =&gt; 子任务1
key1、eventTime1、INSERT =&gt; 子任务2
</code></pre></div></div>

<p>本来连续的两行数据，被路由到两个不同的算子。</p>

<p>接下来从算子B到算子C，执行的是HASH分区：</p>

<blockquote>
  <p>hash 是一种分区策略，用于将数据根据其 key 的哈希值分配到不同的并行任务槽（task slot）上。这种分区方式可以确保相同的 key 始终被分配到同一个任务槽中，从而实现数据的分组操作。</p>
</blockquote>

<p>此时，尽管key1一定会被路由到同一个子任务上，但是顺序已经无法保证了。</p>

<h2 id="接下来把所有算子并行度都修改为12看下效果">接下来把所有算子并行度都修改为12，看下效果</h2>

<p><img src="/assets/images/posts/flink-parallelism-out-of-order/img-02.webp" alt="image" /></p>

<p>这时候从A到B，执行的是forward分区策略。</p>

<blockquote>
  <p>forward 是一种分区策略，用于将数据从上游算子直接传递到下游算子的对应并行实例中，而不进行任何重新分区或重新分配。也就是说，forward 保证了数据会直接从上游的一个并行子任务传递到下游的同一个并行子任务。</p>
</blockquote>

<p>接下来再执行HASH分区，因此呢，同一个KEY的数据的相对顺序并没有改变。</p>

<h2 id="结论">结论</h2>

<p>虽然验证结果还没出来，但是大概率这就是答案了。</p>]]></content><author><name>大斌</name></author><category term="flink" /><category term="流计算" /><summary type="html"><![CDATA[e是事件时间，相同的key、相同的事件时间，写入程序一定是先写入RowKind为DELETE的数据，后写入RowKind为INSERT的数据。]]></summary></entry><entry><title type="html">flink stream转table POJO对象遇到的坑</title><link href="https://shengbinxu.github.io/2024/08/flink-stream-to-table-pojo/" rel="alternate" type="text/html" title="flink stream转table POJO对象遇到的坑" /><published>2024-08-02T12:20:00+08:00</published><updated>2024-08-02T12:20:00+08:00</updated><id>https://shengbinxu.github.io/2024/08/flink-stream-to-table-pojo</id><content type="html" xml:base="https://shengbinxu.github.io/2024/08/flink-stream-to-table-pojo/"><![CDATA[<h2 id="核心代码">核心代码</h2>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">public</span> <span class="kd">class</span> <span class="nc">TrackLog</span> <span class="o">{</span>
    <span class="kd">private</span> <span class="nc">Integer</span> <span class="n">entityId</span><span class="o">;</span>
    <span class="c1">// flink的时间类型，必须使用LocalDateTime</span>
    <span class="kd">private</span> <span class="nc">LocalDateTime</span> <span class="n">statDateTime</span><span class="o">;</span>
	<span class="kd">public</span> <span class="nc">Integer</span> <span class="nf">getEntityId</span><span class="o">()</span> <span class="o">{</span>
        <span class="k">return</span> <span class="n">entityId</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">setEntityId</span><span class="o">(</span><span class="nc">Integer</span> <span class="n">entityId</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">this</span><span class="o">.</span><span class="na">entityId</span> <span class="o">=</span> <span class="n">entityId</span><span class="o">;</span>
    <span class="o">}</span>
	<span class="kd">public</span> <span class="nc">LocalDateTime</span> <span class="nf">getStatDateTime</span><span class="o">()</span> <span class="o">{</span>
        <span class="k">return</span> <span class="n">statDateTime</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">setStatDateTime</span><span class="o">(</span><span class="nc">LocalDateTime</span> <span class="n">statDateTime</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">this</span><span class="o">.</span><span class="na">statDateTime</span> <span class="o">=</span> <span class="n">statDateTime</span><span class="o">;</span>
    <span class="o">}</span>
<span class="o">}</span>

<span class="nc">SideOutputDataStream</span><span class="o">&lt;</span><span class="nc">TrackLog</span><span class="o">&gt;</span> <span class="n">patrolStream</span> <span class="o">=</span> <span class="n">traceStream</span><span class="o">.</span><span class="na">getSideOutput</span><span class="o">(</span><span class="n">outputLogTag</span><span class="o">);</span>
<span class="nc">Table</span> <span class="n">table</span> <span class="o">=</span> <span class="n">tableEnv</span><span class="o">.</span><span class="na">fromDataStream</span><span class="o">(</span><span class="n">patrolStream</span><span class="o">);</span>
<span class="n">table</span><span class="o">.</span><span class="na">printSchema</span><span class="o">();</span>
</code></pre></div></div>

<p>会输出：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>(
  `entityId` INT,
  `statDateTime` RAW('java.time.LocalDateTime', '...')
)
</code></pre></div></div>

<h2 id="问题一-往pojo类tracklog中private-属性isdup未定义getter方法">问题一： 往POJO类（TrackLog）中private 属性isDup，未定义getter方法</h2>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">public</span> <span class="kd">class</span> <span class="nc">TrackLog</span> <span class="o">{</span>
    <span class="kd">private</span> <span class="nc">Integer</span> <span class="n">entityId</span><span class="o">;</span>
    <span class="c1">// flink的时间类型，必须使用LocalDateTime</span>
    <span class="kd">private</span> <span class="nc">LocalDateTime</span> <span class="n">statDateTime</span><span class="o">;</span>

	<span class="kd">private</span> <span class="kt">boolean</span> <span class="n">isDup</span> <span class="o">=</span> <span class="kc">false</span><span class="o">;</span>

	<span class="kd">public</span> <span class="nc">Integer</span> <span class="nf">getEntityId</span><span class="o">()</span> <span class="o">{</span>
        <span class="k">return</span> <span class="n">entityId</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">setEntityId</span><span class="o">(</span><span class="nc">Integer</span> <span class="n">entityId</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">this</span><span class="o">.</span><span class="na">entityId</span> <span class="o">=</span> <span class="n">entityId</span><span class="o">;</span>
    <span class="o">}</span>
	<span class="kd">public</span> <span class="nc">LocalDateTime</span> <span class="nf">getStatDateTime</span><span class="o">()</span> <span class="o">{</span>
        <span class="k">return</span> <span class="n">statDateTime</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">setStatDateTime</span><span class="o">(</span><span class="nc">LocalDateTime</span> <span class="n">statDateTime</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">this</span><span class="o">.</span><span class="na">statDateTime</span> <span class="o">=</span> <span class="n">statDateTime</span><span class="o">;</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p>再运行：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>(
  `f0` RAW('com.tide.entity.TrackLog', '...')
)
</code></pre></div></div>

<p>schema中，只有f0一个field，类型是TrackLog，也就是说，在把POJO类的fields映射到表时，出现了问题。</p>

<p>很奇怪，debug了好久才发现问题所在。</p>

<h2 id="问题二定义了schema但是字段比pojo类中public-field少了一个程序抱错">问题二：定义了schema，但是字段比POJO类中public field少了一个。程序抱错</h2>

<p>代码：</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">public</span> <span class="kd">class</span> <span class="nc">TrackLog</span> <span class="o">{</span>
    <span class="kd">private</span> <span class="nc">Integer</span> <span class="n">entityId</span><span class="o">;</span>
    <span class="c1">// flink的时间类型，必须使用LocalDateTime</span>
    <span class="kd">private</span> <span class="nc">LocalDateTime</span> <span class="n">statDateTime</span><span class="o">;</span>

	<span class="kd">private</span> <span class="kt">boolean</span> <span class="n">isDup</span> <span class="o">=</span> <span class="kc">false</span><span class="o">;</span>

	<span class="kd">public</span> <span class="nc">Integer</span> <span class="nf">getEntityId</span><span class="o">()</span> <span class="o">{</span>
        <span class="k">return</span> <span class="n">entityId</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">setEntityId</span><span class="o">(</span><span class="nc">Integer</span> <span class="n">entityId</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">this</span><span class="o">.</span><span class="na">entityId</span> <span class="o">=</span> <span class="n">entityId</span><span class="o">;</span>
    <span class="o">}</span>
	<span class="kd">public</span> <span class="nc">LocalDateTime</span> <span class="nf">getStatDateTime</span><span class="o">()</span> <span class="o">{</span>
        <span class="k">return</span> <span class="n">statDateTime</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">setStatDateTime</span><span class="o">(</span><span class="nc">LocalDateTime</span> <span class="n">statDateTime</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">this</span><span class="o">.</span><span class="na">statDateTime</span> <span class="o">=</span> <span class="n">statDateTime</span><span class="o">;</span>
    <span class="o">}</span>
	<span class="kd">public</span> <span class="kt">boolean</span> <span class="nf">isDup</span><span class="o">()</span> <span class="o">{</span>
        <span class="k">return</span> <span class="n">isDup</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">setDup</span><span class="o">(</span><span class="kt">boolean</span> <span class="n">dup</span><span class="o">)</span> <span class="o">{</span>
        <span class="n">isDup</span> <span class="o">=</span> <span class="n">dup</span><span class="o">;</span>
    <span class="o">}</span>
<span class="o">}</span>

<span class="nc">SideOutputDataStream</span><span class="o">&lt;</span><span class="nc">TrackLog</span><span class="o">&gt;</span> <span class="n">patrolStream</span> <span class="o">=</span> <span class="n">traceStream</span><span class="o">.</span><span class="na">getSideOutput</span><span class="o">(</span><span class="n">outputLogTag</span><span class="o">);</span>
        <span class="nc">Schema</span> <span class="n">schema</span> <span class="o">=</span> <span class="nc">Schema</span><span class="o">.</span><span class="na">newBuilder</span><span class="o">()</span>
                <span class="o">.</span><span class="na">column</span><span class="o">(</span><span class="s">"entityId"</span><span class="o">,</span> <span class="nc">DataTypes</span><span class="o">.</span><span class="na">INT</span><span class="o">())</span>
                <span class="o">.</span><span class="na">column</span><span class="o">(</span><span class="s">"statDateTime"</span><span class="o">,</span> <span class="nc">DataTypes</span><span class="o">.</span><span class="na">TIMESTAMP</span><span class="o">())</span>
                <span class="o">.</span><span class="na">build</span><span class="o">();</span>
        <span class="nc">Table</span> <span class="n">table</span> <span class="o">=</span> <span class="n">tableEnv</span><span class="o">.</span><span class="na">fromDataStream</span><span class="o">(</span><span class="n">patrolStream</span><span class="o">,</span> <span class="n">schema</span><span class="o">);</span>
</code></pre></div></div>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Caused by: org.apache.flink.table.api.ValidationException: Unable to find a field named 'entityId' in the physical data type derived from the given type information for schema declaration. Make sure that the type information is not a generic raw type. Currently available fields are: [f0]
</code></pre></div></div>

<p>判断：问题不在于POJO类中多了一个field，而在于多了一个Boolean类型的field，不明白为啥Boolean类型会导致问题。</p>

<h2 id="教训">教训</h2>

<h3 id="1当pojo类的fields和表的字段严格一致时不需要指定schema">1、当POJO类的fields和表的字段严格一致时，不需要指定Schema</h3>

<h3 id="2pojo类中如果有boolean类型可能会导致问题当我们的pojo类加入">2、POJO类中如果有Boolean类型，可能会导致问题。当我们的POJO类加入</h3>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="o">{</span>
    <span class="kd">private</span> <span class="nc">Boolean</span> <span class="n">isDup</span> <span class="o">=</span> <span class="kc">false</span><span class="o">;</span>
    <span class="kd">public</span> <span class="nc">Boolean</span> <span class="nf">isDup</span><span class="o">()</span> <span class="o">{</span>
        <span class="k">return</span> <span class="n">isDup</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">setDup</span><span class="o">(</span><span class="kt">boolean</span> <span class="n">dup</span><span class="o">)</span> <span class="o">{</span>
        <span class="n">isDup</span> <span class="o">=</span> <span class="n">dup</span><span class="o">;</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p>不指定schema情况下，输出：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>(
  `f0` RAW('com.tide.entity.TrackLog', '...')
)
</code></pre></div></div>

<p>去掉这个field，输出的table schema就正常了。</p>

<h2 id="谜底揭晓">谜底揭晓</h2>

<p>经过百般尝试，发现问题不在于Boolean类型，而在于IDEA为boolean类型生成的getter、setter方法不符合flink的标准。</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">public</span> <span class="nc">Boolean</span> <span class="nf">isDup</span><span class="o">()</span> <span class="o">{</span>
        <span class="k">return</span> <span class="n">isDup</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">setDup</span><span class="o">(</span><span class="kt">boolean</span> <span class="n">dup</span><span class="o">)</span> <span class="o">{</span>
        <span class="n">isDup</span> <span class="o">=</span> <span class="n">dup</span><span class="o">;</span>
    <span class="o">}</span>
</code></pre></div></div>

<p>修改为：</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code> <span class="kd">public</span> <span class="kt">boolean</span> <span class="nf">getIsDup</span><span class="o">()</span> <span class="o">{</span>
        <span class="k">return</span> <span class="n">isDup</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">setIsDup</span><span class="o">(</span><span class="kt">boolean</span> <span class="n">dup</span><span class="o">)</span> <span class="o">{</span>
        <span class="n">isDup</span> <span class="o">=</span> <span class="n">dup</span><span class="o">;</span>
    <span class="o">}</span>
</code></pre></div></div>

<p>程序一切正常了。</p>

<p>因此，POJO类的规范至关重要：</p>

<ol>
  <li>每个private field必须定义标准的getter、setter方法</li>
  <li>注意一定是标准的getter、setter方法。</li>
</ol>

<p>后面再抽时间看看，flink如何把POJO类映射成table schema的。（大概率是反射）</p>]]></content><author><name>大斌</name></author><category term="flink" /><category term="flink sql" /><summary type="html"><![CDATA[schema中，只有f0一个field，类型是TrackLog，也就是说，在把POJO类的fields映射到表时，出现了问题。]]></summary></entry></feed>